Ciencia abierta · IA aplicada
Pipette.
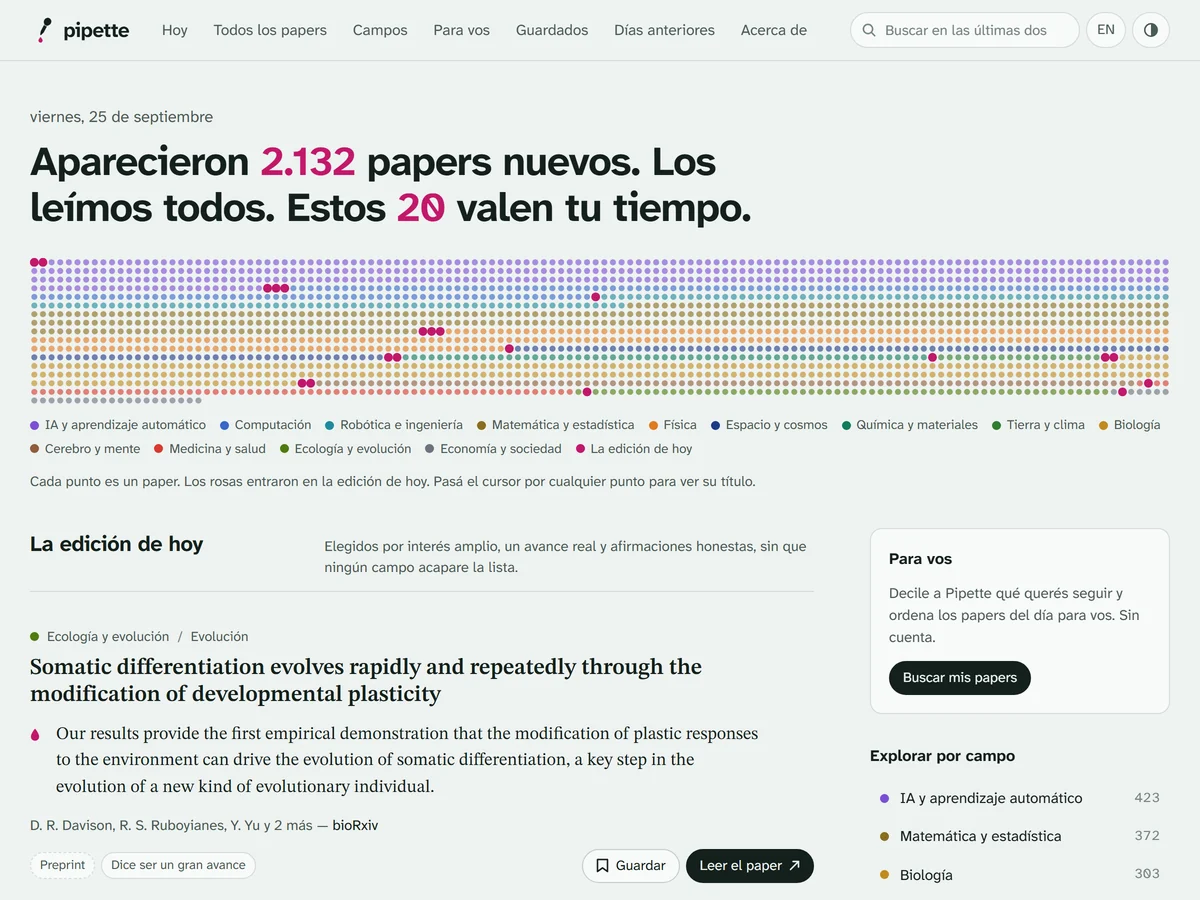
Pipette lee cada mañana todos los papers nuevos de arXiv, bioRxiv, medRxiv y 58 revistas líderes, y publica una edición corta de los que vale la pena conocer. Nunca reescribe la ciencia: de cada paper cita la oración del resumen que dice el resultado principal. Es gratis, sin publicidad, sin cuentas y de código abierto.
- Resultado
- Dos mil papers leídos por día, gratis y sin publicidad.
- Tiempo
- Lanzado en septiembre de 2026
- Con qué está hecho
- Next.js, Python, AWS Lambda, S3, Jev (TypeSafe), Vercel
Cómo fue el proyecto
Por qué nos contactaron
Cada día aparecen miles de papers nuevos y la IA está por multiplicar ese número. Las herramientas existentes sirven para buscar algo puntual o resumen con IA poniendo palabras en boca de los científicos.
Qué problema tenían
Encontrar lo importante de cada día sin leer dos mil resúmenes, sin que un campo tape a los demás y sin que una máquina invente lo que dice un paper.
Cómo lo resolvimos
Usamos Jev, un modelo de decisión que no genera texto: solo elige entre opciones y da probabilidades calibradas. Le hacemos diez preguntas a cada paper, elegimos con una fórmula pública y mostramos siempre las palabras de los autores.
Enfoque técnico
Una AWS Lambda diaria en Python lee arXiv, bioRxiv, medRxiv y OpenAlex, consulta a Jev y publica JSON abierto en S3. El sitio es Next.js en Vercel, en castellano e inglés, con páginas por campo y tema, sitemaps con todos los papers, datos estructurados y avisos por IndexNow.
Impacto
Unos dos mil papers leídos por día hábil, con un costo de modelo de alrededor de 17 centavos de dólar. Los datos se publican con licencia CC0 y el código es abierto en GitHub.
Cuánto tardó
Lanzado en septiembre de 2026.
Qué necesitó el cliente
Ninguno: es un producto propio de Ferced, hecho y mantenido gratis para quien lea ciencia.
Fricción del proceso
Media: ordenar ciencia de todos los campos con criterio honesto, en dos idiomas y sin generar texto, pedía reglas editoriales claras además de código.